MolScience
开放分子科学数据库
为化学研究、教学与人工智能应用整理可追溯、可检索的分子结构与性质数据。
为什么需要 MolScience
化学数据库是文献调研、结构确证、性质查询与合成设计的入口。当这个入口变得昂贵、封闭或不可持续时,受影响的不只是检索效率,还有谁能参与研究。
MolScience 的目标不是再做一个静态的化学信息网站,而是建设可以长期积累、检索、计算并服务科研与教学的化学数据基础设施。它首先服务于化学问题,其次才是技术展示。
我们同样在意数据对机器是否友好。可靠的结构、性质与来源信息,是模型训练、检索服务和知识发现的共同基础。
我们在建设什么
当前工作围绕一条分子记录的生命周期展开:它如何被定义、从哪里来、经过什么处理、以什么方式被检索和使用。
- 分子身份与结构表示:处理立体化学、盐、溶剂化物、多组分体系与互变异构等边界。
- 来源与溯源:区分数据库记录、实验测量、软件计算与模型预测,保留来源、方法和原始值。
- 标准化与实体对齐:把不同来源的名称、结构与性质记录映射到同一对象,并完成清洗、去重与质量评价。
- 检索与服务:支持文本、结构与性质检索,让数据既能被研究者使用,也能被软件和模型调用。
- 性质数据与预测接口:在可靠数据基础上集成描述符、指纹与预测方法,并清楚表达不确定性——这部分仍在规划与探索中。
我们如何判断一条记录
对数据库而言,“有数据”不等于“可以使用”。一条记录至少需要回答三个问题:它描述的是哪个化学实体?这个值来自哪里?它适合回答什么问题?
因此我们把来源、方法、版本和原始值作为记录的一部分,而不是附注。预测值不会被伪装成实验值,不同来源之间的冲突也不会被平均值掩盖。
工程与协作
项目以开源方式建设,代码托管在 MolScienceX 组织下。技术栈以成熟、可交接的开源方案为主,目标是让新成员能够读懂、复现并继续维护,而不是依赖某一个人的记忆。
数据合规是前提。外部数据的许可需要逐类核查,保留来源标识;宁可慢一点,也不在许可上留下缺口。
如何参与
MolScience 能容纳不同背景的成员:化学方向可以参与数据定义、来源核验与科学判断;计算机与人工智能方向可以参与数据工程、检索、模型和平台;设计与产品方向可以改善信息架构与科研使用体验。
如果你是第一次接触这个项目,可以从一条数据、一个检索问题或一份文档开始,而不是先等待一个宏大的任务。
当前进展
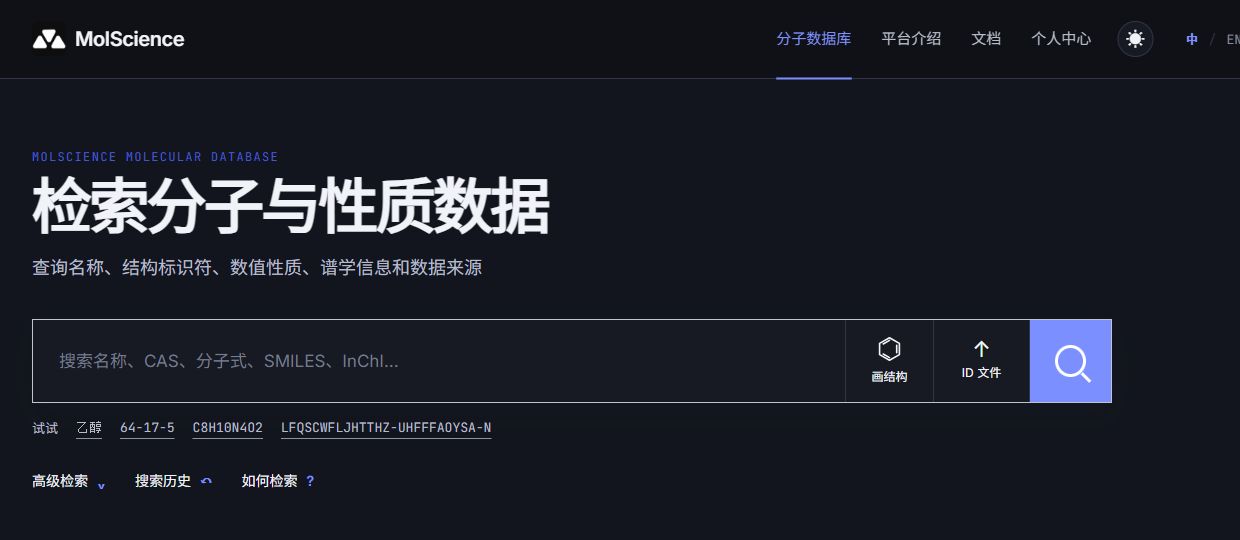
- molscience.org 已上线,作为项目的公开入口。
- 已有数据库原型,以及数据导入、整理与检索的工程积累。
- 正在完善分子身份、结构表示、来源标识与数据质量评价。
边界与未完成
- 尚不是可以替代商业数据库的完整产品,功能和数据覆盖都在建设中。
- 更大规模的分子空间、规模化性质预测与反应数据平台属于长期目标,不是当前已实现的能力。
- 部分外部数据的许可仍在逐类核查,公开范围会受此约束。
MolScience 是独立产品,拥有自己的域名与产品网站。本页是 ChemAI 视角的项目介绍,不重复实现其数据库功能。